我们经常看到这种 URL:
|
|
这些后缀不是装饰,它们规定了一套完整的请求和响应数据结构。选错了,代码要么报错,要么丢数据。
这篇文章从 /v1/completions 开始,一路讲到 /v1/responses,把每个后缀代表什么、为什么这么设计、哪些地方容易踩坑说清楚。
一个 URL 后缀代表一套协议 #
先拆一个典型的 API 路径:
|
|
/v1 约束的是请求字段、响应字段、错误格式、流式事件格式、工具调用格式。同一个模型可能同时支持多种协议,同一个协议也可能被不同厂商支持,但兼容程度不完全一样。
所以问题的本质是:你需要先确认目标平台支持哪种协议,然后按这个协议的规范发请求、收响应。
/v1/completions:文本续写的旧时代
#
早期的 LLM 只做一件事:给你一段文本,预测后面的文本。
|
|
模型不知道什么是"系统消息",什么是"用户输入",什么是"助手回复"。如果你想做对话,得自己拼:
|
|
这有两个问题。第一,模型得靠文本格式猜哪部分是谁说的,给了 prompt injection 更多机会。第二,对话历史没法结构化输出,所有上下文都在一整段字符串里。遇到工具调用或图片输入,根本没法优雅处理。
现在这个接口基本是遗留产物了。OpenAI 官方文档把它标记为 Legacy。
/v1/chat/completions:过去几年最重要的协议
#
这是目前兼容性最好的 LLM API。几乎所有主流厂商都支持或兼容它。
|
|
messages 是核心 #
messages 数组里的每个对象有 role 和 content:
system:系统指令,定义模型行为边界user:用户输入assistant:模型之前的回复tool:工具调用结果
这比手动拼 User:、Assistant: 高明得多。上下文从字符串变成了一组有角色、有顺序的消息对象。
兼容性分层 #
“兼容 OpenAI API"这句话经常被厂商拿来做营销,但兼容是有层级的:
|
|
大部分"兼容 OpenAI"的平台只做到 Level 2 或 Level 3。换平台之前先测一下你要用的功能到底支不支持。
为什么生态这么好 #
因为基础设施已经建好了。SDK、代理、网关、前端聊天软件、RAG 框架都支持 OpenAI Chat Completions 协议。切换平台通常只需要改三个东西:
|
|
但"能跑"和"完全兼容"是两回事。
/v1/messages:Claude 的消息协议
#
Anthropic 选了一条不同的路。
|
|
和 OpenAI 的差异主要在三个地方。
system 是顶层参数 #
OpenAI 把 system 放在 messages 数组里,和其他消息混在一起。Claude 把它提出来作为顶层字段。看起来是小事,但解析逻辑完全不同。
content 是 block 结构 #
Claude 的 content 可以是字符串,也可以是 content blocks——文本、图片、工具调用结果都是不同类型的 block。
响应解析路径也不同:
|
|
还有 stop_reason、usage.input_tokens、usage.output_tokens 这些字段名也不一样。
不能混用 #
OpenAI 和 Claude 的接口结构不兼容,不能直接替换。需要一个适配层做转换。很多第三方平台声称支持 Claude 协议,但实际只是在 OpenAI 兼容层上套了个壳,Claude 特有的功能(比如 extended thinking)不一定能用。
/v1/responses:统一响应对象
#
OpenAI 在 2025 年推出的 Responses API 是对 Chat Completions 的重新设计。
|
|
为什么需要新协议 #
/v1/chat/completions 的名字里有两个历史包袱:chat 和 completions。当初的设计假设是用户给一段聊天历史,模型补全下一条消息。
但现在的模型不只聊天了。它要读图片、处理音频、查文件、搜网页、调函数、用代码解释器、维护服务端上下文、输出结构化 JSON、返回推理摘要。把这些全塞进 chat.completion 对象,越来越别扭。
Responses API 的设计思路是:输入是任务、上下文和可用工具,输出是包含文本、工具调用和中间结果的完整响应对象。
|
|
新项目应该关注它 #
如果只是做简单聊天,/v1/chat/completions 仍然够用,生态兼容性最好。
但如果涉及工具调用、网页搜索、文件搜索、代码解释器、多模态输入、复杂流式事件、服务端状态、agent workflow,Responses API 更合适。
Google Gemini:RESTful 资源风格 #
Gemini 的路径长这样:
|
|
拆开看:
/v1或/v1beta:API 版本/models/{model}:模型资源:generateContent:对这个资源执行的方法
这是 Google API 的标准风格——对某个资源执行某个操作。和 OpenAI、Anthropic 的命名风格明显不同。
数据结构也不一样。Gemini 用 contents + parts,而不是 messages:
|
|
v1 是稳定版本,v1beta 是预览能力。生产环境用 v1,想尝鲜再考虑 v1beta。
/v1/embeddings:向量化接口
#
这个接口把文本变成浮点数向量:
|
|
返回:
|
|
典型用途是 RAG:用 /v1/embeddings 把文档切片转成向量存入数据库,用户提问时把问题也转成向量,检索最相似的文档片段,再塞进聊天接口生成答案。如果想从零搭建 RAG 系统,可以参考 https://blog.baifan.site/rag-system-complete-guide-langchain-ollama-pgvector/。
embedding 负责找资料,聊天接口负责生成答案。两个接口各司其职。
/v1/models:模型列表
#
|
|
查询账号可用的模型、检查模型名称是否正确、动态展示模型选择列表。调试 404 model_not_found 错误时也靠它。
为什么一定要有 /v1
#
很多人以为 /v1 是第一代模型,/v2 是第二代。这是错的。
/v1 是 API 版本,不是模型版本。
|
|
这四个不是一回事。
API 版本的存在是为了向后兼容。如果厂商改了响应结构,老代码就废了。所以通常的做法是新开一个版本(/v2)或新增一套接口(/v1/responses),而不是在同一个版本里做破坏性变更。
Base URL 和 Endpoint 的区别 #
很多软件配置时会问你填 Base URL 还是 Endpoint。这两个不一样:
|
|
如果软件让你填 Base URL,不要带 /chat/completions,因为 SDK 会自动拼接。填错了,实际请求可能变成:
|
|
然后报 404。
经验规则:
- Base URL / API Base / OpenAI Base URL:填到
/v1 - Endpoint / Full URL / Request URL:填完整路径
- Provider:选协议类型(OpenAI、Anthropic、Gemini)
- Model:填模型 ID,不填 URL
响应结构不同,解析代码不能混用 #
这是最容易踩坑的地方。四种协议的响应结构都不一样:
|
|
写错了不是报错就是拿到空值。切换平台时,响应解析逻辑必须跟着改。
流式输出的格式也不一样。OpenAI 用 data: {"choices":[{"delta":{"content":"Hel"}}]},Anthropic 用 event: content_block_delta 这种事件流格式。同一个 stream: true 参数,背后的实现完全不同。
主流厂商协议对照表 #
| 厂商 | 接口路径 | 协议风格 | 主要用途 |
|---|---|---|---|
| OpenAI | /v1/responses |
OpenAI 新一代 | 多模态、工具、agent、新项目优先 |
| OpenAI | /v1/chat/completions |
Chat Completions | 传统聊天、兼容生态 |
| Anthropic | /v1/messages |
Anthropic 原生 | Claude 对话、工具、多模态 |
/v1/models/{model}:generateContent |
Google REST 风格 | Gemini 稳定接口 | |
| Mistral | /v1/chat/completions |
OpenAI-like | 聊天、工具调用 |
| xAI | /v1/chat/completions |
OpenAI-like | Grok 对话 |
| DeepSeek | /chat/completions |
OpenAI-like | DeepSeek 对话模型 |
| Groq | /openai/v1/chat/completions |
OpenAI-compatible | 高速推理 |
| OpenRouter | /api/v1/chat/completions |
OpenAI-compatible | 多模型聚合路由 |
怎么选 #
- 简单聊天:
/v1/chat/completions,生态最成熟 - 新项目接 OpenAI,需要现代能力:
/v1/responses - 接 Claude 官方:
/v1/messages,别强行套 OpenAI 壳 - 接 Gemini:
/v1/models/{model}:generateContent - 做 RAG:
/v1/embeddings+ 任意聊天接口 - 接第三方聚合服务:先确认它兼容哪种协议,再选 SDK。如果想自建 API 代理,可以参考 https://blog.baifan.site/self-hosted-ai-api-pipeline/。
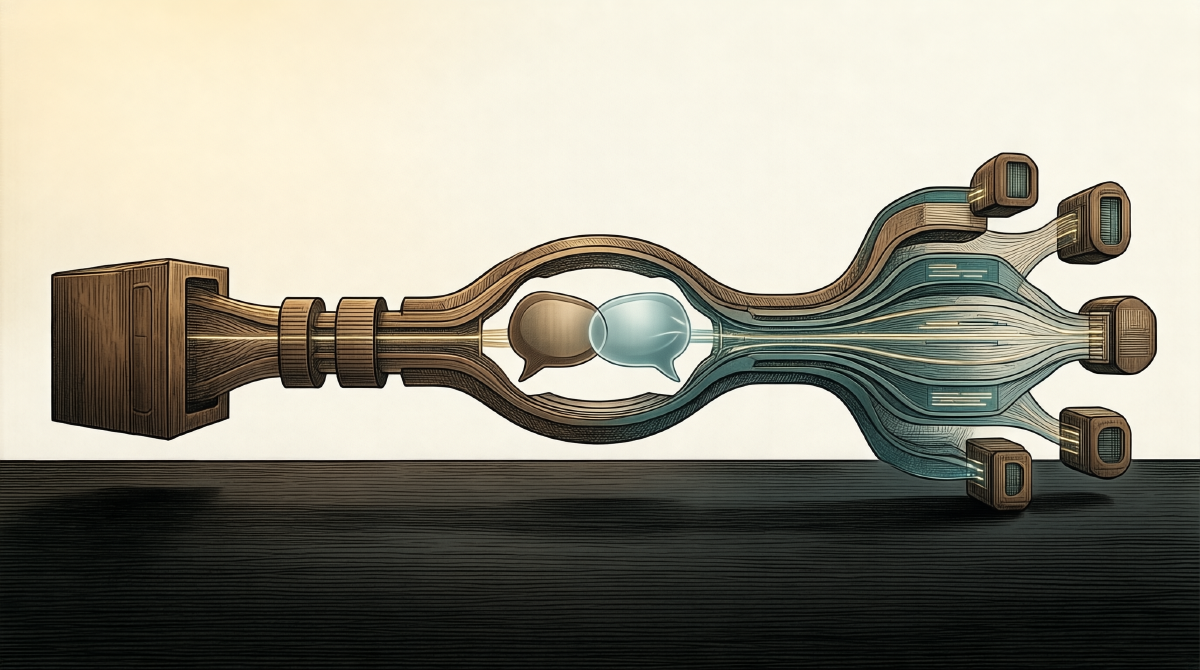
一个图总结 #


协议不兼容是常态,兼容是例外。选对协议、填对 Base URL、解析对响应结构,这三件事做对了,调 API 就没什么坑了。