
深度思考
·
2026-06-02
·
8 分钟
AI 的记忆系统:四种记忆类型与语义召回
上一篇文章聊了上下文压缩——它解决的是"当前会话能记住多少"的问题。但编程助手还需要另一种记忆:跨会话的长期记忆。
3582 字
阅读 ➔
上一篇文章聊了上下文压缩——它解决的是"当前会话能记住多少"的问题。但编程助手还需要另一种记忆:跨会话的长期记忆。
大模型在物理底层不存在真正意义上的生物记忆,只有在显卡高带宽内存(HBM)中随序列长度线性堆叠的 Key-Value Cache,以及在数学上随序列拉长而被急剧稀释的注意力权重分布。Claude Code 呈现给开发者的所谓长程对话能力,本质上是一套在硬件显存与精度边界夹缝中运行的缓存逐出流水线,伴随着不可逆的信息失真与前缀失效代价。
任何运行在宿主机用户态、依赖模型自律与应用层正则拦截的 AI Agent 权限系统,在操作系统内核视角下都不构成强制安全边界。Claude Code 设计的五级权限模型与交互式审批机制,是一套降低开发误操作概率的人机协作流控协议,在恶意对抗场景下缺乏沙箱约束力。
如果你以为 System Prompt 就是"给 AI 设定一个人设",那 Claude Code 的 system prompt 会颠覆你的认知。 它不是几句话。它是一个上千行的模板引擎,由多个层次组成,每一层负责不同的事:身份定义、行为约束、工具说明、项目上下文、记忆注入、技能加载。有些层是静态的(每次一样),有些层是动态的(根据项目、会话、用户偏好实时注入)。
上一篇文章我们聊了 Think-Act-Observe 循环——AI 编程助手的骨架。骨架本身不会干活,它需要肌肉。在 Claude Code 里,肌肉就是工具。 没有工具,循环里 Think 和 Observe 之间缺了 Act,退化回普通的问答。有了工具,模型才能触碰真实世界:读你的代码、改你的配置、跑你的测试。
如果你把 Claude Code 的源码翻一遍,你会发现一个反直觉的事实: 整个程序的核心,是一个 while 循环。 不是复杂的状态机,不是精巧的管道,不是分布式协调——就是一个朴素的 while 循环,反复做三件事:让模型想、让模型动手、把结果喂回去。
用 AI 写代码,最烦的不是它写错,而是它每次都用不同的方式写错。同一个需求,对话三次,三种写法。规范在你脑子里,AI 不知道。 Trellis 试图解决这个问题。它不是又一个 AI 编码助手,而是一套给 AI 注入项目规范的框架——让 AI 写代码之前先读你的规范,写完之后自动检查,检查完之后把新学到的东西沉淀回规范里。用得越多,AI 越懂你的项目。
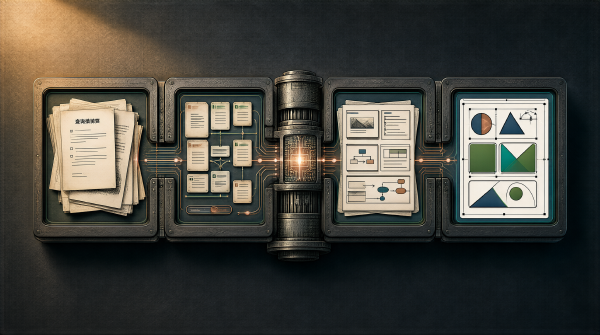
市面上绝大多数所谓 AI PPT 工具,本质上只是“输入主题 → 套用死板模板 → 输出低质排版”的玩具。要真正达到商业交付水准,核心在于将生成链路解构为带确定性约束的多阶段流水线:从需求调研与资料检索,到大纲策划与版面规划,再到利用 SVG Bento Grid 结构化渲染。
SSH 到服务器上跑个长任务,网络断了,任务没了。Tmux 就是解决这个问题的——把终端会话和窗口解绑,关了终端进程还在跑。 Tmux 三层结构:Session 包含 Window,Window 包含 Pane 解决的核心问题 # 普通终端窗口和进程绑在一起。关窗口,进程就没了。SSH 断线同理。
我们经常看到这种 URL: 1 2 3 /v1/chat/completions /v1/messages /v1/responses 这些后缀不是装饰,它们规定了一套完整的请求和响应数据结构。选错了,代码要么报错,要么丢数据。 这篇文章从 /v1/completions 开始,一路讲到 /v1/responses,把每个后缀代表什么、为什么这么设计、哪些地方容易踩坑说清楚。