多 Agent 协作的技术内核:价值来自结构,不是并发
多 Agent 系统的实际收益从不源于节点数量的盲目堆叠,而取决于拓扑结构的工程约束。缺乏严格职责边界与通信契约的多 Agent 系统只是昂贵的低效并发——成倍消耗 Token 并在链路中放大模型幻觉;具备分层委派、状态隔离与确定性验证闭环的架构,才是可工程化的复杂系统。
先讲一件真实发生的事。 2025 年初,我给内部系统加一个功能:导出 Excel。需求很小,我甚至没写文档,直接在对话框里打了句"给列表页加个导出按钮"。
AI Agent 运行时动态干预的思考 # 几周前的一个深夜,我盯着终端里不断刷新的的 Agent 日志,急得想砸键盘。它正按部就班地生成一份需求分析报告,已经跑了十几分钟,拉取了大量数据、画了图表,眼看就要收尾——我突然意识到,需求里漏了一个关键维度:“别按地区分,按用户年龄段分”。如果我此时打断它,之前所有的上下文、中间结果、工具调用状态全都得丢弃,重头再来。如果不打断,它很快就会产出一份我需要花同样时间手动修改的错误报告。
开源社区每天都在涌现海量 Agent 扩展与 MCP 服务,但超过九成的扩展在装上之后便永久吃灰。工具链的价值在于其调用契约与上下文开销是否可控。以下从长期实测的高频工具中按真实场景分类梳理。
12 篇文章,我们从 Think-Act-Observe 循环一路拆解到 50 万行的工程深渊。现在站在系列的终点,回头看整条演进路径,一个更大的问题浮出水面: AI 编程工具最终会演化成什么样子?
claude-code-from-scratch 项目用大约 3000 行 TypeScript 实现了一个"迷你版 Claude Code"。它有 Think-Act-Observe 循环、工具系统、System Prompt、权限控制、记忆、Skill、多代理、MCP——我们在前面 10 篇文章里拆解的核心概念,它全都有。
自回归大语言模型在缺乏外部强约束时,天然存在向局部贪婪变异发散的病态冲动。Claude Code 的 Plan 模式通过外挂离散有限状态机(FSM),将动作空间硬性投影至零副作用的只读子集,利用人机交互屏障强制在决策树上切断代价高昂的物理回溯分支。
在 MCP 出现之前,每个 AI 工具集成都是一次定制开发。想让 ChatGPT 连数据库?写一个插件。想让 Claude 调 GitHub API?写一个 Function Calling 定义。想让 Copilot 访问你的内部系统?写一个 Custom Tool。
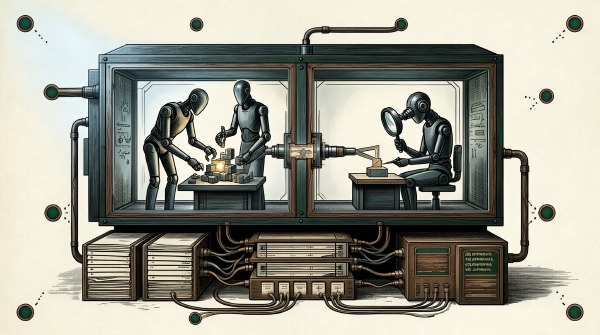
有一个反直觉的现象:同一个模型,拆成多个独立实例让它协作,效果往往比单个实例更好。 不是算力增加了(三个实例的总 token 消耗比一个实例多),不是能力提升了(每个实例都是同样的模型)。提升来自角色分离——当每个 Agent 只关注问题的一个方面时,它做得比"全能 Agent"更专注、更深刻。
如果你用过 Claude Code,你可能注意到它有一个 /skills 命令,可以列出已安装的"技能"。写作规范、架构设计方法、TDD 流程、代码审查策略——听起来像一个插件市场。