维护 dev-skills 到第十几个 Skill 的时候,我意识到自己其实不知道它们有没有用。每次演示都能看到漂亮的输出,但这些输出没有对照,没有因果——我只知道挂了 Skill 之后发生了什么,不知道不挂的话会发生什么。
最初的判断方式 #
最早的判断方式很简单:写完一个 Skill,塞进 Claude Code,跑一个任务,看输出是否符合预期。grill 技能的第一个版本就是这样通过验收的——我丢了一份有并发问题的服务设计,Agent 挑出了锁竞争,我觉得有效。
后来我补做了一次不挂 Skill 的运行。同一份设计,同一个模型,模型依然指出了锁竞争,只是表达方式略有不同。
单点演示测的是模型能力,不是 Skill 的净增益。
dev-skills 的设计初衷在https://blog.baifan.site/claude-code-skills-system/里有完整记录——Skill 是给模型按需注入的行为规约,前提是它能让模型做出不同且更好的行为。“更好"二字,需要有对照基线才能成立。
第一次设对照组:任务书写坏了 #
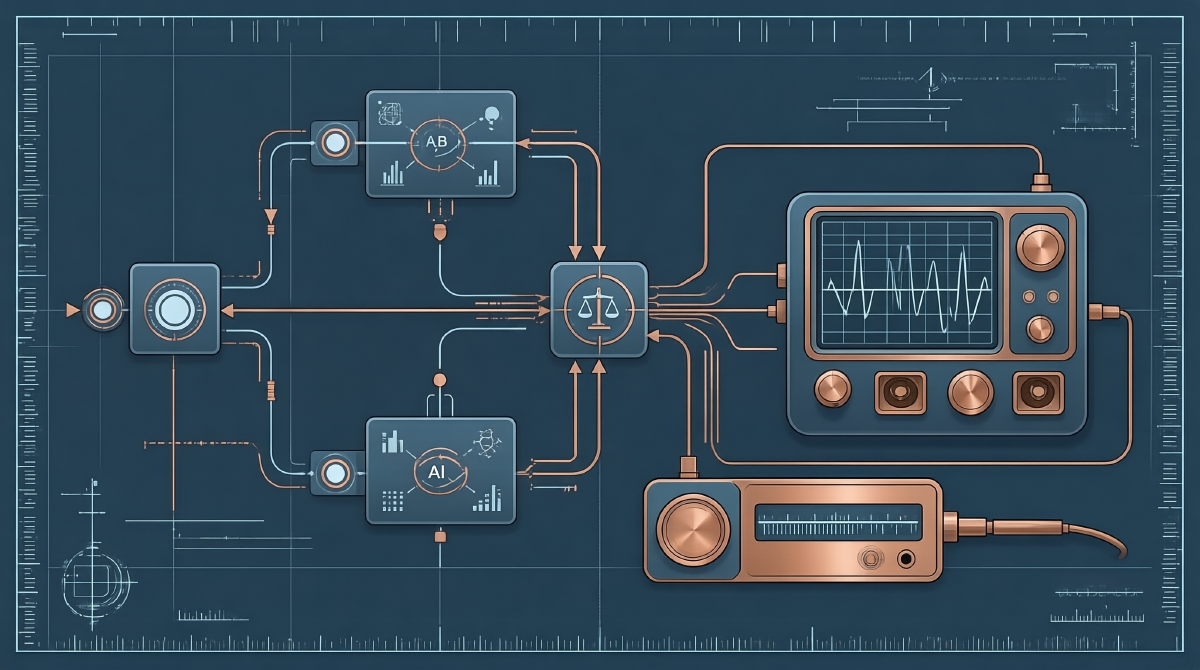
意识到需要对照组之后,我开始做配对实验:同一任务,两条臂,一条挂 Skill,一条不挂,模型版本、温度、随机种子全部相同。
第一次正式跑对照组,任务是评审一个分布式缓存的设计文档。结果两条臂输出几乎一致,打平。
我检查任务书,找到了原因:我在任务描述里写了"请仔细评估潜在的竞争条件和资源泄漏风险”。这句话把 grill Skill 内部要求模型做的动作直接喂给了基线臂,任务书污染了对照组,两臂从起点就不公平了。
这个错误之后,任务书的写法有了硬规定:只陈述目标(要评审什么)、上下文(系统背景)、硬性约束(不能改动的接口和依赖)、交付物形态(需要什么格式的报告)。凡是能和 Skill 规约条文对应的推理动作,禁止出现在任务书里。
执行起来比说起来难。任务书写得越自然,越容易带入 Skill 的方法论痕迹。我目前的做法是写完任务书后,逐条对比 Skill 文本,检查有没有方法论动词——“检查”、“分析”、“确认”、“确保"这类词出现时要特别警惕。
评分靠 LLM Judge:掉进另一个坑 #
任务书问题解决后,下一个坑是评分。
最初我把两份交付物丢给另一个模型,让它判断哪份更好。这个方案成本低、自动化程度高,看起来合理。
结果没有信噪比。LLM judge 系统性偏好更长的回答,偏好 Markdown 格式更清晰的,偏好段落结构更整齐的。这和交付物有没有真正发现架构缺陷完全无关。谁的报告更像"咨询报告格式”,谁就胜出。
现在的打分分三层,硬的优先。
第一层是确定性检查:能跑脚本验证的,全部用脚本。隐藏测试套件的退出码,Linter 是否报错,特定 API 是否被正确调用。这层不涉及任何主观判断,Exit Code 0 或 1,没有灰色地带。
第二层是金标准清单:在被测任务里预埋若干已知缺陷,评审员只做布尔命中核查——Skill 臂找到几个,基线臂找到几个。grill 的评测就是这样做的:我在被评审的设计里预埋 5 个缺陷(并发时序竞争、连接池泄漏、缓存击穿、降级策略缺失、监控盲区),用召回率作为主要指标。“感觉上更专业"这种评价从来不进入报告。
第三层才是人工盲评,用于有主观维度的交付物。交付物脱敏、移除工具链调用元数据,两名评审员交叉评阅且顺序对调,打分时必须引原文标出至少两处具体硬伤,不允许只给分不给据。
成本维度是后来才想到的 #
前面三个问题解决之后,我以为框架基本够用了。
后来跑 think Skill(交互澄清类,编码前主动提问收敛需求边界)的对照实验,质量差值显示 Skill 臂在特定场景下召回了更多隐式需求,胜出。我记录了结论,认为 think 有效。
后来补统计 Token 消耗,发现 think 的静态注入加上它诱发的多轮交互,每次任务平均多消耗约 12,000 Token。对偶发性、需求模糊的任务,这个代价说得过去;但如果把它常驻于所有任务上下文,包括需求完全清晰的,就是纯浪费。
这次之后,评测报告必须附带两张独立账本:质量差值和成本差值,不合并打分。合并需要预设一个质量与成本的折算系数,这个系数因业务场景而异,不该由评测框架替团队做决定。
grill 的成本更极端:完整运行一次多消耗约 30,000 Token。但如果它能在上线前拦截一个分布式并发死锁,这个代价对于有高并发要求的服务可以忽略——前提是你的服务确实面临这类风险,而不是给一个单机脚本跑 grill。成本与收益的折算没有统一答案,但账本必须透明摊开。
现在的流程 #
目前的评测大致按这个顺序走:
难度校准:先不挂任何 Skill 盲跑任务,测基线通过率。超过 80% 说明任务太简单,基模型已经能轻松应对,挂不挂 Skill 差别不大——需要重新注入隐式边界条件或干扰性假根因,把基线通过率压到 40%–70% 的区间。这步繁琐,但跳过它,整套评测失去区分度。
并行双臂执行:物理沙盒隔离,唯一变量是上下文里有没有 Skill 文本及其全部依赖文件(完整闭包)。
哈希同一性检查:如果两臂输出 MD5 完全一致,说明任务存在单一确定解,测试样本直接废弃,不参与统计。这种情况常出现在要求精确格式转换的任务上。
确定性检查优先:能用脚本判断的,先判断,不进入主观环节。
脱敏盲评:移除工具链调用元数据后才交给评审员,评审员不知道哪份来自哪条臂。
双账本报告:质量差值和成本差值并列,不合并打分。
什么样的 Skill 值得被写出来 #
做完评测之后,我对这个问题有了截然不同的判断。
最常见的误解是把 Skill 当成写给模型看的技术文档——越完整、越系统越好。但文档是写给能反复翻阅、随时定位的人类的。Skill 不是。一份 Skill 注入上下文之后,要在同一个注意力计算里和任务书、代码片段、工具调用结果、模型预训练权重同时竞争。任务越复杂,上下文越长,Skill 的有效注意力份额越小。模型在执行压力下会自动退化回训练时见过最多的做法,不是 Skill 里写的步骤。
这个前提决定了写 Skill 的逻辑,和写文档的逻辑是两套东西。
流程说明的问题
“先写失败测试,再写实现,再重构”——看起来清晰,写进 tdd 后模型在前两步执行得还行,重构步骤经常自行跳过。更普遍的是,模型先把实现写完,然后补一个会失败的测试,形式上满足了"先有失败测试"的文字描述,实质上完全绕过了 TDD 的约束意图。
流程说明把"执行顺序"当成了约束,但顺序只是文字,不是执行锁。没有可观测的检查点,模型就会在压力下自行重排步骤。
方案解释的问题
“先写测试是因为后补测试约束不了实现阶段的设计决策,只能覆盖幸福路径”——这是方案解释。模型能从解释中推断出新情境的正确处理方式,这是方案解释相对于流程说明的优势。
但方案解释的代价是 Token,而 GPT-4o、Claude Sonnet 4、Gemini 2.5 Pro 这代模型,训练数据里已经包含了海量关于"为什么要 TDD"“为什么做架构评审"的讨论。这些知识早就内化在权重里了。在 Skill 里重新解释一遍,是在用上下文预算买安心感,不是在改变行为。
随着模型能力提升,这个问题只会加重。解释常识的字越多,越是浪费。
负向约束比正向指令更有效
“总是澄清需求边界"和"不要在需求存在歧义时直接开始实现”——两句话描述同一件事,但后者在测试里持续胜出。
原因是:模型已经有"努力完成任务"的正向预设,正向指令在强化一个本来就存在的倾向,增量有限。负向约束是在压制一个具体的默认行为,压制目标明确,执行时有迹可查。
这个规律在 grill 里体现得最清楚。“找出所有潜在风险"几乎没有效果——模型本来就会找它认为存在的风险。“确认四个死锁前提条件(循环依赖、持锁等待、不可剥夺、互斥占用)同时成立才能下断言,不要把竞态条件和死锁混用”——这条约束是在封堵一个具体的错误模式,效果可以在预埋缺陷的召回率里直接测出来。
示例比规则更省 Token
一对"坏的 / 好的"示例在测试里的行为迁移效果,通常好于等字数的抽象规则描述。原因在于模型的学习机制:预训练本质上是从海量示例中归纳模式,上下文里出现的示例会激活相同的归纳机制。
这不是说规则没用——示例覆盖不了的边界情况,还是需要规则兜底。但如果一条规则能用一个具体的坏案例和对应的好案例来表达,优先用示例。
模型能力增长让 Skill 的有效内容持续收缩
tdd 在 Claude 3 时代的主要内容是"如何写有意义的测试”——流程加解释,大约 1,500 Token。随着 Claude Sonnet 4 的测试能力大幅提升,这部分全部成了废话。现在有效的内容只剩三类硬约束:提交时序约束(测试文件的修改时间必须早于实现文件)、命名约束(测试名必须描述失败场景,test_valid_case 这类名字不允许存在)、断言强度约束(assertTrue(result is not None) 这类零信息断言视为无效测试)。其余删掉了。
这个趋势指向一个结构性结论:一份 Skill 里解释通用最佳实践的内容,随着基础模型的迭代,有效期越来越短。真正有长期价值的内容是:这个项目、这个团队的运行上下文里,模型的默认"正确"行为在哪些地方是错的。这类知识不在训练数据里,不会随模型升级而自动内化,是 Skill 的唯一不可替代部分。
一个检验标准
写任何一条 Skill 规范之前,先问:不写这条,模型会不会自己做正确的事?
“大概率会”——这条是冗余的,删掉。
“不会,而且我有实测案例支撑这个判断”——这条有存在价值。
好的 Skill 是压缩后的差异化工程约束,不是压缩前的最佳实践综述。字越少,每个字的注意力份额越高,执行越稳定。
还没有好答案的地方 #
交互类 Skill 的评测至今是个麻烦。think 的价值在于主动提问,但评测环境里没有真实用户。我用受控模拟器(维护一份隐藏需求档案,两臂提出相同问题时返回相同答案)来隔离交互噪声,但模拟器无法还原真实用户的模糊表达和理解偏差。用模拟器测出"有效”,不等于面对真实用户也有效。
另一个问题是 Skill 内部的非均质性。https://blog.baifan.site/give-ai-a-rulebook/里提到过,规则集里往往只有少数条文真正起作用,其余的是冗余或负优化。现在的框架能判断整个 Skill 是否有净收益,但无法精确定位哪几条规范在起作用,哪几条应该删掉。这个粒度的问题目前还没有令我满意的解法。
评测框架本身也是成本,不要以为有了框架就有了答案。