
技术管理
·
2026-10-11
·
9 分钟
AI 编码的下一阶段,是重造研发系统
团队里每个人敲代码的速度翻了几倍,最终交付却没有变快。敲键盘提速产生的代码洪峰,直接把下游的评审队列和集成流水线冲垮了。瓶颈没有消失,只是从编辑器转移到了代码审查和上线验证。
4140 字
阅读 ➔
团队里每个人敲代码的速度翻了几倍,最终交付却没有变快。敲键盘提速产生的代码洪峰,直接把下游的评审队列和集成流水线冲垮了。瓶颈没有消失,只是从编辑器转移到了代码审查和上线验证。
维护 dev-skills 到第十几个 Skill 的时候,我意识到自己其实不知道它们有没有用。每次演示都能看到漂亮的输出,但这些输出没有对照,没有因果——我只知道挂了 Skill 之后发生了什么,不知道不挂的话会发生什么。
在构建代码智能体(Coding Agent)的运行时架构时,传统的单步工具调用(Tool-Calling Loop)正在遭遇工程瓶颈:面对多文件重构与跨模块分析,单步 JSON RPC 往返导致交互轮次爆炸与上下文急剧膨胀,且无法高效表达工具间的异步依赖。为了突破这一调度天花板,Pi Coding Agent 的 CodeMode 与 DeepSeek Harness(CLI: dsh)的 PTC(Programmatic Tool Calling,编程式工具调用)模式给出了两条截然不同的代码执行路线。
在任何一家号称“全面接入 AI”的企业技术团队里,最不能细看的账单通常不是生产环境的推理开销,而是那一堆为了自欺欺人而跑出来的评估流水线(Eval Pipelines)。
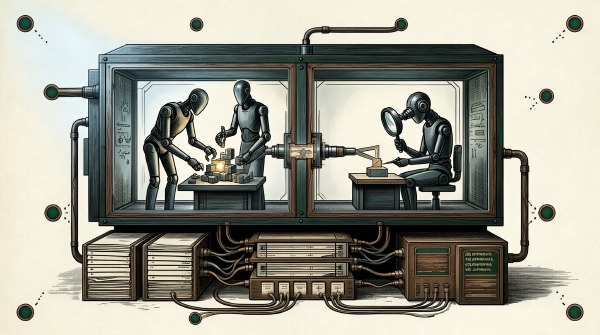
多 Agent 系统的实际收益从不源于节点数量的盲目堆叠,而取决于拓扑结构的工程约束。缺乏严格职责边界与通信契约的多 Agent 系统只是昂贵的低效并发——成倍消耗 Token 并在链路中放大模型幻觉;具备分层委派、状态隔离与确定性验证闭环的架构,才是可工程化的复杂系统。
AI Agent 运行时动态干预的思考 # 几周前的一个深夜,我盯着终端里不断刷新的的 Agent 日志,急得想砸键盘。它正按部就班地生成一份需求分析报告,已经跑了十几分钟,拉取了大量数据、画了图表,眼看就要收尾——我突然意识到,需求里漏了一个关键维度:“别按地区分,按用户年龄段分”。如果我此时打断它,之前所有的上下文、中间结果、工具调用状态全都得丢弃,重头再来。如果不打断,它很快就会产出一份我需要花同样时间手动修改的错误报告。
开源社区每天都在涌现海量 Agent 扩展与 MCP 服务,但超过九成的扩展在装上之后便永久吃灰。工具链的价值在于其调用契约与上下文开销是否可控。以下从长期实测的高频工具中按真实场景分类梳理。
附件下载:Agent 面试题整理.pdf — 方便打印或离线阅读 为什么需要多个 Agent # 开场问题,用来区分"看过文章"和"动手搭过"。
67 MB 的 DMG 安装包,解压后 164 MB,里面藏着 Anthropic 的 Claude Science(内部代号 Operon)。逆向之后,我看到了 54 张 SQLite 表、9 层安全模型、30 多个生物信息学 Skill,以及一个面向计算生物学的完整 AI Agent 平台。
为什么 AI Agent 需要记忆系统? # 如果你有过长时间使用 AI Agent 的经验,一定对以下场景不陌生: