生产环境突发大面积用户登录瘫痪,网关频繁返回 502 Bad Gateway,认证服务 Casdoor 持续报 503。终端执行 df -h 检查根分区,磁盘空间使用率仅为 40%,尚有 55GB 可用空间,系统底层却四处抛出 no space left on device(ENOSPC)。这起事故的根源在于一个被遗忘 6 个月的 PHP 遗留容器,因垃圾回收机制失效与爬虫流量持续涌入,在单级目录下堆积了 571 万个 0 字节 Session 文件,将宿主机文件系统仅有的 635 万个 inode 彻底耗尽。
故障现象与干扰信号 #
早间运维监控与用户反馈群同时报警:生产环境应用门户(portal.example.com)全站无法登录。
运维排查的第一现场呈现出三个互相矛盾的特征:
- 业务接口看似正常:业务核心 API 网关日志里绝大多数只读查询依然稳定返回
200 OK,服务进程并未崩溃; - 认证刷新全线阻断:只要用户发起登录认证、换取凭证或刷新权限,网关立刻抛出
502 Bad Gateway; - 多个健康容器集体误报:执行
docker ps -a检查容器运行时,宿主机上 4 个以上的核心 AI 业务容器同时处于Up 4 days (unhealthy)状态。
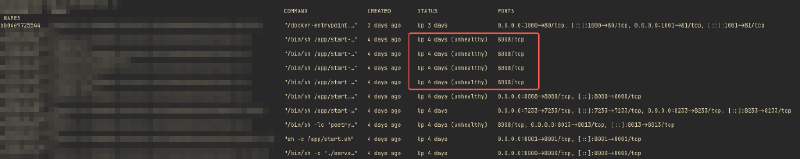
在多服务并存的微服务环境中,看到核心业务容器集体被标为 unhealthy,最常见的下意识动作往往是盲目重启容器。但在未定位物理层根因之前执行重启,不仅无法恢复业务,还会因为无法重新创建容器命名空间与临时配置文件而导致服务直接彻底宕机。
提取其中一个 unhealthy 容器的健康检查原始退出日志:
|
|
注意报错主体:这是 dockerd 在宿主机侧 调用底层 runc exec 进入容器执行探测脚本时,尝试在宿主机的 /tmp 目录下写入用于进程序列化的临时状态文件失败。容器内部的业务服务本身依旧存活,健康检查探针在跨越宿主与容器的边界时被拦截在宿主机侧。这种健康检查探针自身的实现依赖反噬业务可用性判断的现象,在分布式系统与探活机制设计中屡见不鲜,相关状态判决逻辑可参考《https://blog.baifan.site/distributed-system-heartbeat-mechanism/》中的分析。
链路排查与「空间充足」的物理矛盾 #
顺着用户认证调用链路,从反向代理网关逐级向下钻取日志:
|
|
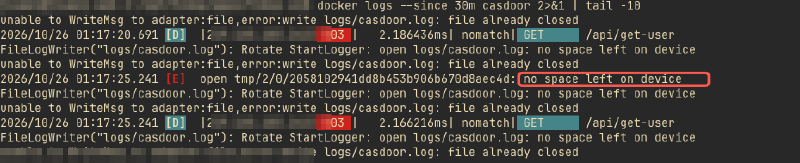
调用链路完全闭环:Casdoor 认证服务在处理鉴权换票与轮转日志时需要写入临时文件,写入触发系统级 no space left on device 错误,导致 Casdoor 抛出 503;上游用户管理服务捕获异常后返回上游系统错误;顶层网关由于上游响应异常直接吐出 502。
但在宿主机执行常规磁盘检查时,却遇到了反常现象:
|
|
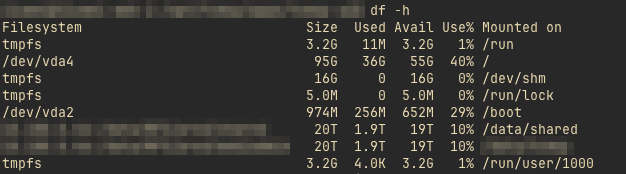
系统根分区容量 95GB,实际使用 36GB,空闲 55GB,空间使用率仅仅 40%。常规基于磁盘使用率(如空间占比 > 85%)的监控规则完全处于静默状态。这种监控指标表面正常但深层功能已经彻底瘫痪的断层,正如《https://blog.baifan.site/ai-mttr-mtbf-resilience-psychosis/》所述,是典型指标异化带来的观测盲区。
inode 定罪与逐级空间下钻 #
在 Linux 内核与 POSIX 文件系统规范中,创建任何一个新文件都必须同时满足两个物理条件:
- 数据块(Data Block)充足:用于存储文件的实际内容字节;
- 索引节点(Inode)充足:用于存储文件的元数据(权限、属主、时间戳、文件大小及指向数据块的指针)。
任何一方耗尽,内核系统调用 open(..., O_CREAT) 或 creat() 都会直接返回 ENOSPC(Error No Space)。
执行 df -i 检查文件系统元数据利用率:
|
|
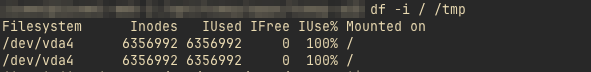
全盘 635 万个 inode 被彻底占满,可用节点数 IFree = 0。不仅运行中的服务无法写入临时文件,甚至连管理员在终端执行依赖临时文件的管道操作(例如数据量稍大的 sort)都会直接崩溃退出。
定位究竟是哪个目录在疯狂吞噬 inode:
|
|
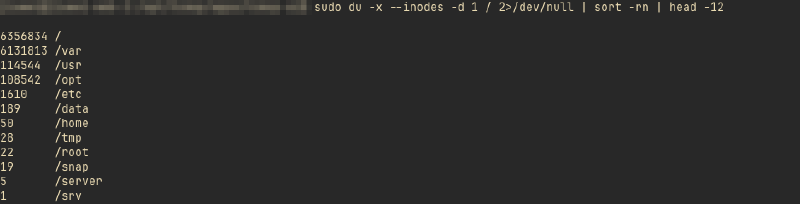
从输出可见,/var 目录独占 613 万个 inode,占比超过 96.5%。
沿着 /var 继续向下排查 Docker 目录结构:
|
|
全机 90% 的 inode 集中在 Docker 的一个匿名卷 073a7d1a... 中。
抽样查看该卷中的文件详情:
|
|
571 万个文件直接平铺在该目录根部,文件名全部遵循 sess_* 模式,属主全为 www-data,且绝大多数文件大小都是 0 字节。
反查该卷绑定的容器:
|
|
元凶浮出水面:这是一个半年前部署的旧版 PHP 5.4 遗留业务容器(lsp_old),在后台静默运行了整整 6 个月。
由于 inode 耗尽导致系统无法分配临时文件,常规依赖临时缓冲的命令会报错,我们使用原地内存哈希聚合统计这些文件的创建时间分布:
|
|
| 时间跨度 | 文件数量 | 占比 | 业务状态与性质 |
|---|---|---|---|
| 30 天前(4月 ~ 9月) | 4,856,271 | 85.0% | 历史无用冷死文件 |
| 7 ~ 30 天 | 687,633 | 12.0% | 已超期无效会话 |
| 7 天内 | ~166,000 | 2.9% | 近期生成空会话 |
| 最近 24 小时 | 0 | 0.0% | 最后写入停留于前日 09:14(inode 耗尽锁死) |
按时间推算,该容器平均每天产生约 3.2 万个全新的空 Session 文件(平均每 2.7 秒产生一个)。全盘 0 字节特征表明:公网网络爬虫与漏洞扫描器每次发起无 Cookie 的匿名探测,PHP 在执行 session_start() 时都会视为新会话并创建空文件,而这些连接随后被丢弃,空会话永远不会写入数据,也不会被业务逻辑显式销毁。
根因深度剖析:为什么原生清理机制全部失效 #
按常理,PHP 内置了 Session 垃圾回收(Garbage Collection)逻辑,为什么 6 个月内 571 万个文件能毫发无损地堆积下来?
这是典型的 概率论设计缺陷、目录时间复杂度膨胀与容器运行契约脱节 叠加导致的系统性失效。
1. PHP 概率 GC 在海量文件下的时间复杂度死锁 #
PHP 原生文件型 Session 的垃圾回收并非后台独立守护进程,而是依附在普通的 HTTP 请求生命周期内。
GC 的触发完全是一个概率事件,由配置项决定:
$$\text{Trigger Probability} = \frac{\text{session.gc\_probability}}{\text{session.gc\_divisor}}$$默认情况下通常是 $1 / 1000$。一旦某次请求命中了那千分之一的概率,该 PHP 工作进程会在单线程内执行如下清理流程:
- 调用
opendir()打开session.save_path目录; - 逐一遍历目录内的每一个文件项;
- 对每个文件执行
stat()系统调用,获取文件的修改时间(mtime); - 计算
current_time - mtime,若差值大于session.gc_maxlifetime(默认 1440 秒 / 24 分钟),则调用unlink()删除。
关于底层元数据检索开销与目录遍历性能问题,在《https://blog.baifan.site/git-add-silent-failure-stat-cache-plumbing/》中关于系统级元数据检索代价的推导同样适用。当单级目录下的文件数量达到数万甚至数十万时,执行遍历所需的磁盘 I/O 耗时呈指数级上升;当膨胀至 571 万个文件时,单次目录遍历所需的时间远远超出了 PHP 默认的 max_execution_time(通常为 30 秒)。
其物理结果是:每次好不容易触发了 GC,PHP 进程在刚刚扫描到极小一部分文件时就因请求超时被内核信号直接 SIGTERM 杀死。而并发的其他 HTTP 请求如果再次命中 GC,又会陷入新一轮的长时间 I/O 阻塞。最终垃圾回收逻辑在海量小文件形成的 I/O 泥潭中彻底停摆。
2. 容器化直接击穿了 Linux 发行版的维护契约 #
在 Debian 与 Ubuntu 官方维护的 PHP 软件包中,系统维护人员为了避免上述前端请求遭遇不可控的 I/O 延迟抖动,默认在 php.ini 中将 session.gc_probability 直接硬编码为 0:
|
|
发行版的设计意图是将清理职责转交给操作系统的 cron 定时任务(例如 /etc/cron.d/php),由 root 用户每天或每半小时在后台异步执行扫描清理脚本。
但当应用被打包封装进 Docker 容器后,原有的系统级运维契约被直接击穿:
- 容器内部:只运行了 Nginx 与 PHP-FPM 前台进程,容器内根本没有启动
cron或systemd守护进程; - 宿主机外部:宿主机的 cron 脚本只知道扫描宿主机的
/var/lib/php/sessions,完全无法感知 Docker 卷隔离目录下的容器挂载路径; - 配置覆盖:该遗留镜像的
php.ini保留了 Debian 系默认的session.gc_probability = 0,没有针对容器环境进行适配调整。
三重真空并存:PHP 自身不触发 GC,容器内没有调度器,宿主机扫描不到卷目录。571 万个空文件得以在半年的无管状态下持续蚕食文件系统元数据。
修复方案与紧急处置 #
在 inode 完全耗尽的故障现场,一切新增文件的操作均不可用。处置过程必须严格保证操作的幂等性与内存稳定性。
阶段一:紧急止血(已执行) #
在处理数百万级小文件堆积时,严禁使用常规的 rm -rf * 命令。在 Bash 下,通配符 * 会在命令执行前由 Shell 展开为全部文件名。单目录包含 571 万个参数时,会直接突破 Linux 内核的 ARG_MAX(通常为 2MB ~ 4MB 内存上限),抛出 Argument list too long 错误。
必须使用内核级系统调用进行流式逐个解除链接(unlink):
|
|
该命令的工程考量如下:
- 直接调用内核
unlink():-delete参数由find内部直接调用系统调用删除文件,绕过 shell 参数展开与额外进程 fork; - 精准时间分界线:限制删除 30 天以前的冷死文件(共 4,856,271 个),既释放了全盘 76% 的 inode,又彻底规避了误删近期可能依然活跃的会话数据;
- 安全可重入:若执行过程中被中断,重新运行命令依然会继续从中断处向后清理,无副作用。
执行完成后复查元数据使用情况:
|
|
全盘 inode 使用率从 100% 骤降至 24%,释放出 485 万个可用 inode。Casdoor 鉴权服务随即自动恢复临时文件写入,用户管理服务重试成功,全站登录功能在未重启任何核心业务服务的情况下瞬间自愈。
阶段二:遗留容器治理与彻底根治 #
针对 lsp_old 遗留容器,制定两级治理策略:
- 业务评估与容器下线:经确认,该 PHP 5.4 容器为历史过渡项目,最后一次业务有效更新在 6 个月前,核心接口已由新微服务接替。在业务侧完成灰度下线确认后,停止该容器并彻底删除对应匿名卷,永久回收剩余的 85 万个无用文件;
- 若遗留系统必须保留的保底方案:
- 方案 A(存储解耦):改用 Redis 存储 Session(配置
session.save_handler = redis),利用 Redis 内置的键值过期(TTL)机制实现自动无感销毁,将状态从本地文件系统中彻底剥离; - 方案 B(宿主定时巡检):在宿主机配置 systemd timer 或 cron 定时任务,每日执行轻量级清理,严控生命周期:
1 2# 清理超过 3 天未访问的过期会话文件 find /var/lib/docker/volumes/073a7d1a.../_data -maxdepth 1 -name 'sess_*' -mtime +3 -delete
- 方案 A(存储解耦):改用 Redis 存储 Session(配置
经验教训与监控防线补全 #
这起事故呈现了单点技术欠债通过底层文件系统击穿全局高可用架构的完整过程。系统防护需在以下四个维度补全短板:
1. 监控指标不能出现结构性盲区 #
磁盘监控仅关注 df -h(空间容量)是绝大多数运维体系中最致命的盲区。对于包含日志切割、缓存目录、Session 存储、邮件队列或临时工作区的服务器,小文件耗尽 inode 的概率远高于数据块耗尽。
在 Prometheus Node Exporter 中必须强制配置 inode 监控规则:
|
|
2. 警惕健康检查(Healthcheck)反噬系统可用性 #
Docker 的 HEALTHCHECK 命令是在宿主机侧拉起 runc exec 进程,依赖宿主机的 /tmp 与运行时命名空间写入能力。当底层资源耗尽时,健康检查往往比业务进程本身更先崩溃。
在微服务架构中,健康检查必须与上层编排调度器的自愈动作(如自动重启、滚动替换)设置安全熔断机制。当全机出现批量健康检查异常时,首要排查宿主机公共基础设施(文件句柄、进程数、inode、网络命名空间),禁止无差别重启业务容器。
3. 规范 Docker 存储卷生命周期 #
严格限制生产环境匿名卷(Anonymous Volume)的随意创建。匿名卷往往缺乏明确的项目属主与清理归属,容易成为无人认领的垃圾滋生地。所有有状态持久化挂载均需采用具名卷或规范化的宿主机目录挂载,并纳入统一备份与生命周期管理。
4. 消除「无人敢动」的幽灵遗留系统 #
一个年久失修、缺乏文档的 PHP 5.4 容器,以每天 3.2 万个空文件的速度,用 180 天时间默默吃光了整台物理机的元数据表。在微服务演进过程中,旧系统下线必须与新系统上线遵循相同的工程严格度,下线流程中不仅要切断入口流量,必须彻底回收计算、存储与卷资源,杜绝僵尸进程在暗处持续消耗宿主资源。
附录:应急排查用只读命令清单 #
在 inode 耗尽、系统拒绝写入任何临时文件的极端环境下,以下只读命令均不依赖宿主机临时磁盘空间,可安全执行:
|
|