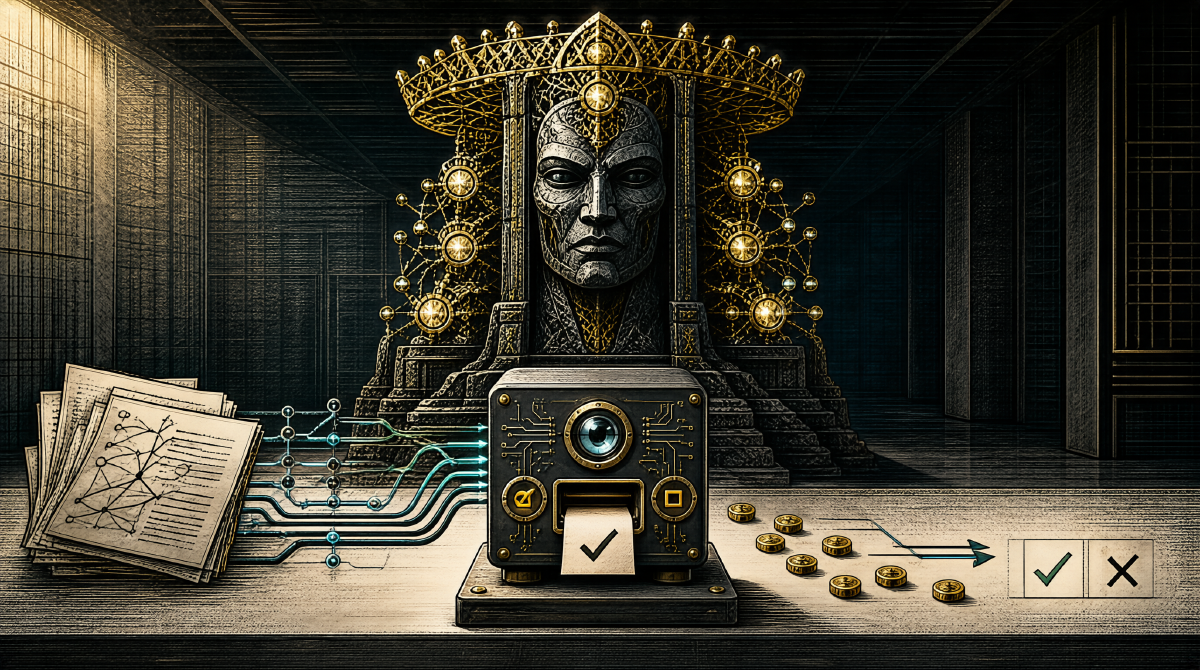
在任何一家号称“全面接入 AI”的企业技术团队里,最不能细看的账单通常不是生产环境的推理开销,而是那一堆为了自欺欺人而跑出来的评估流水线(Eval Pipelines)。
过去三年,企业技术栈里最庞大、最神圣、同时也最经不起推敲的图腾,莫过于“企业私有知识库”——它后来被包装成 RAG,最近又与时俱进地升级成了挂着知识图谱标签的 GraphRAG。每个架构师在向 CTO 画架构图时,都会信誓旦旦地画上最后一环:“闭环评估与持续对齐”。
而在这一环里,整个行业达成了一种近乎病态的默契:LLM-as-a-Judge(让大模型当法官)。
逻辑听起来无可挑剔:用户的提问是千奇百怪的自然语言,检索出来的文档切片是支离破碎的上下文,生成的答案也是不可预测的文本。写传统的单元测试?根本无法写断言。于是,大家心照不宣地掏出最贵的方法:调 GPT-5 或者 Claude Sonnet,把用户提问、检索切片、生成回答,以及从 Neo4j 拓扑里捞出来的三元组,一个不漏地塞进上下文,再附上一段八股式提示词:“请你作为一位极度严谨的首席审计官,一步一步评估以下回答的准确性,并最终以标准 JSON 格式给分……”
然后,整个行业耐着性子等它吐几百乃至上千个 Token 的官样散文,再祈祷这段文本末尾的正则解析不要因为一个换行符而崩溃。
最近,LangChain 针对 TypeSafe AI 的新模型 Jev 写了一份评测(参考推文:https://x.com/LangChain/status/1870634284704099080),用一种极其克制的语气给这场闹剧泼了盆冷水。凡是在生产环境里被评估狠狠教育过的工程师,看这篇文章时一定都能感同身受。结论用一句话浓缩:
我们每家公司未必能烧掉上百亿 token 的钱,但一定能明白:为了证明回答“质量”,把评审判给 gpt-5 或 Claude 写 Essay,是企业最无谓的昂贵行为;而 Jev 的类型化布尔输出,仅需 0.00035 美元。
一、质检员的工资,是流水线工人的二十倍 #
在展开 Jev 之前,先把企业知识库与 GraphRAG 的成本结构看清楚。
RAG 的初衷,本来是用企业私有数据给 LLM 建一个“事实底座”,标准做法是不管你怎么组织 RAG,都要先把“评估”这一环扣上。
假设你已经搭好一套企业级知识库,用户平均的每个问题会走进这样的链路:
- 向量数据库召回约 5 个相关的文档 Chunk;
- GraphRAG 沿着实体抽取,遍历了 3 层的社区摘要(Community Summaries),拼出一张看起来很完整的知识图谱;
- 生成模型综合所有资料,输出一段 200 字左右的回答。
这一段的生产推理成本:约 $0.002。
然而“评估阶段”才是重头戏。为了证明这个系统是值得依赖的,评估流水线会对这一次生成进行三项“质检”,每个维度都是一次完整的 LLM 调用:
- 真实性(Faithfulness/Groundedness):回答中的每一项主张,是否有检索文档作为依据?
- 相关性(Context Relevance):召回的文档是否与问题真正相关,有无无关噪音?
- 实体一致性(Entity Consistency):知识图谱中抽取的实体与回答中的对位是否一致,有没有张冠李戴?
三个维度,三次完整打分,每次都需要把生产时的完整上下文(8K~16K token)再打包一遍,重新喂给大模型。
最终为这条问答付出的评估成本:约 $0.05,外加 4 秒级 P99 延迟的等待。
也就是说,你的质检成本,是生产成本的 25 倍。($0.05 / $0.002)
更讽刺的是,最后帮你把关的“枪口”,也是一个大模型——用大模型检查大模型,等于用一次不确定去度量另一次不确定,谁能说得清数字和数字之间的时间差呢。
二、一场只有 5 个样本的“处刑” #
为了让对比足够直观,LangChain 内部做了一个小实验:
他们用一个“查天气”的 Agent 的 5 条真实输出,放大成 5×100 次的评估样本,把以下四个模型各自“当法官”的表现拉出来遛:
| 测评模型 | 二元判定准确率 | 打分方差(越低越稳定) | 单次调用成本 |
|---|---|---|---|
| Jev | 100.0% | 0.0000149 | $0.00035(0.44s) |
| GPT-5.6 Luna | 96.4% | 433× 基准 | 未披露 |
| GPT-5.6 Terra | 99.8% | 913× 基准 | 未披露 |
| Claude Sonnet 4.6 | 80.0% | 92× 基准 | $0.05634(慢) |
几个值得注意的差异:
- 二元判定上,Claude Sonnet 4.6 是垫底的(80%)——“谁答得更好”这类二元判断由它做,反而翻车;
- 方差是最大的黑马:GPT-5.6 Terra 系列方差达到 Jev 的 913 倍,意味着在输入完全一样的情况下,它今天给 4 分、明天可能给 2 分——这种波动会让任何 CI 回归形同虚设;
- 单次成本差一个数量级:Jev 一次 0.00035 美元,Claude 一次 0.05634 美元——相差 160 倍;同样的评测全集,Claude 烧掉 $28.17,而 Jev 只需要 $0.34。
一切评估成本被压到了一个史无前例的价位,也意味着“全量评估”从预算上第一次成为可行方案——而不只是部署前的一二则抽测。
三、Jev 的角色:分类器,还是救世主? #
那么 Jev 的实现,是不是真的像官方说的“一种全新的思路”?
TypeSafe AI 的定义:
- 模型不做自回归生成,不产生 token 流输出;
- 输入:Context(检索/上下文状态)+ Answer(生成结果)等结构化内容;
- 输出:固定维度的类型化结果(bool / score / Noul)+ 置信度。
那我把它翻译得更直白:把输入编码起来,过一层分类头,输出概率结果。这个东西你从 2019 年起就很熟了——它是 BERT 时代的常见做法,如今只是从“Sentiment / NLI 分类”换成“评估任务的分类”。
这当然不是一个“横空出世”的东西,反而让人觉得熟悉且踏实:
- 评估一个回答“是否忠于材料”→ 本质是 NLI(自然语言推理);
- 评估“检索是否相关”→ 本质是 re-ranking / 相关性分类。
- 而这些类型,早已有稳定而低成本的技术在长期提供。
换句话说,Jev 让我们在正确的时点,重新看到了那个被遗忘的战术选项:用分类器解决问题的确定性,而不是让 LLM 即兴发挥。
四、末尾:评估的重心回移 #
最后一段话,我并不是只因为它是博客而写。
过去一年多的“LLM-as-a-Judge”盛行,掩盖了一个基本的工程事实:大多数评估判断,本质上是稳定的、可分类的——而不是需要“临场生成文稿”的。
Jev 告诉我们(或者说提醒我们):
- 把评估成本压下来,允许全量执行;
- 用“布尔 + 置信度”的确定输出,代替“一篇800字评论里的模糊分”;
- 把 LLM-Judge 只在真正需要生成式判断时才用。
三件事如果能同步做到,谁都不需要“选择不信”。那么工程上被兜了一圈的“评估马拉松”,会回归它本来就该做的样子。
这应该才是这次 LangChain 评测真正输送的信号:别再玄学兜底了,请把评估还给确定性——用分类器去分类,这句话值得成为每个工程团队口头禅。
分类器又成了救世主——这次,是真的。